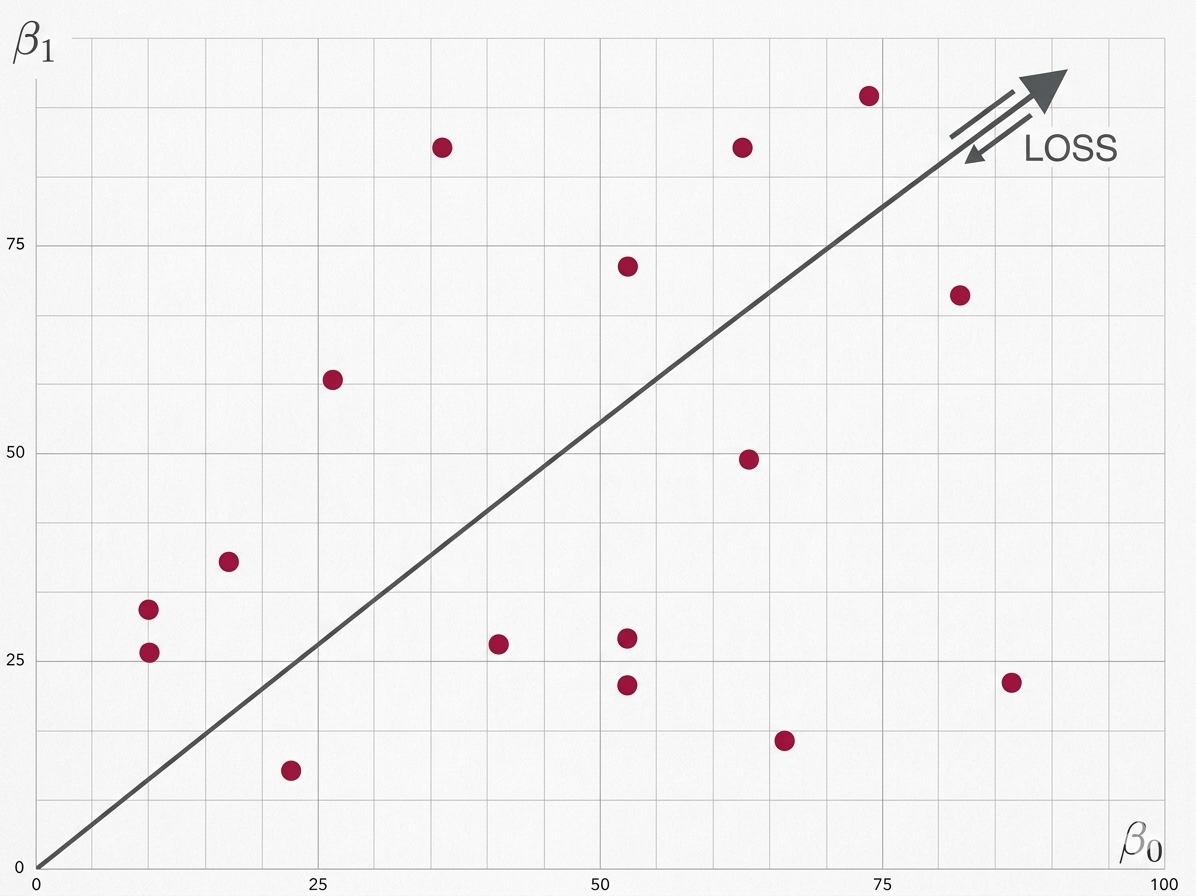
圖中的橫軸 \(\beta _{0}\) 和縱軸 \(\beta _{1}\) 代表線性回歸模型(例如 \(y = \beta_0 + \beta_1 x\))的兩個模型參數(權重/權重與偏置)。
這張圖的核心意義可以拆解為以下幾點:
1. 點與線的代表意義
- 紅色圓圈(點):代表不同的參數組合 \((\beta_0, \beta_1)\)。當你隨機初始化或在訓練過程中嘗試不同的參數時,每一個組合都是二維平面上的一個點。
- 黑色的對角斜線:代表一條隨著參數增加,損失值(Loss)不斷增長的趨勢線。箭頭指向右上角並寫著「loss」,意味著當 \(\beta _{0}\) 和 \(\beta _{1}\) 的數值愈大時,模型在訓練資料上的誤差(Loss)也就愈高。
2. 機器學習的優化目標(Optimization)
- 尋找最小損失:機器學習訓練的目標是「最小化損失函數(Minimize Loss)」。
- 尋找最佳參數:根據這張圖的 loss 箭頭方向(往右上增加),最理想的參數組合應該要往左下角(靠近原點 \((0,0)\) 的方向)尋找,因為那裡的 Loss 值最低,代表模型預測最準確。
3. 實務上的應用情境
這種圖表通常出現在以下教學或分析情境:
- 網格搜尋(Grid Search):將不同的 \(\beta _{0}\) 與 \(\beta _{1}\) 組合代入模型中,計算並畫出它們的 Loss,藉此觀察 Loss 在參數空間中的分佈形狀(例如等高線圖)。
- 梯度下降法(Gradient Descent):用來演示演算法如何從高 Loss 的區域(右上),一步步沿著梯度的反方向,走向量測誤差最小的區域(左下)。